deepseek
满血推理 · 深度求索未至之境
杭州深度求索自研新一代纯强化学习推理大模型。融合 DualPipe 双向流水并行与 Multi-Head Latent Attention 创新注意力架构,实现超低算力开销下的殿堂级数学、代码与长思维链自我修正能力。
SECTION 01 // CORE REASONING CAPABILITY
纯强化学习突破 · 长思维链反思与自纠错
DeepSeek-R1 不依赖人类先验监督微调数据,完全基于强化学习在数学、编码及复杂逻辑推演中自主涌现出反思与纠错机制。在面对极度困难的高阶学术问题时,模型可自主分配数十万步思考预算,大幅降低大模型幻觉率。
DualPipe 架构
双向流水重叠通信与计算,极致挖掘集群吞吐上限。
AIME / MATH 突破
在权威国际奥赛基准上取得与国际顶尖模型匹敌的得分。
开源普惠生态
完整开源模型权重与训练论文,赋能全球开发者自由蒸馏。
SECTION 02 // RIGOROUS BENCHMARK EVALUATION
官方权威基准测试性能对比
| 评估基准分类 | 测试任务 (Metric) | DeepSeek-R1 (满血) | Claude-3.5-Sonnet | GPT-4o (Omni) |
|---|---|---|---|---|
| 高阶数学 | AIME 2024 (Pass@1) | 79.8% | 65.3% | 69.1% |
| 高阶数学 | MATH-500 (Pass@1) | 97.3% | 78.3% | 74.6% |
| 专业代码 | Codeforces (Percentile) | 96.3% (Top 4%) | 93.7% | 90.2% |
| 专业代码 | SWE-bench Verified | 49.2% | 49.0% | 38.8% |
| 通用逻辑 | MMLU (Pass@1) | 90.8% | 88.7% | 88.5% |
极致降本增效
每百万输入 Token 仅需 1.0 元,缓存命中低至 0.14 元,颠覆传统高昂算力门槛。
OpenAI SDK 兼容
无需修改核心业务逻辑,仅需替换 base_url 与 API Key 即可极速完成无缝迁移。
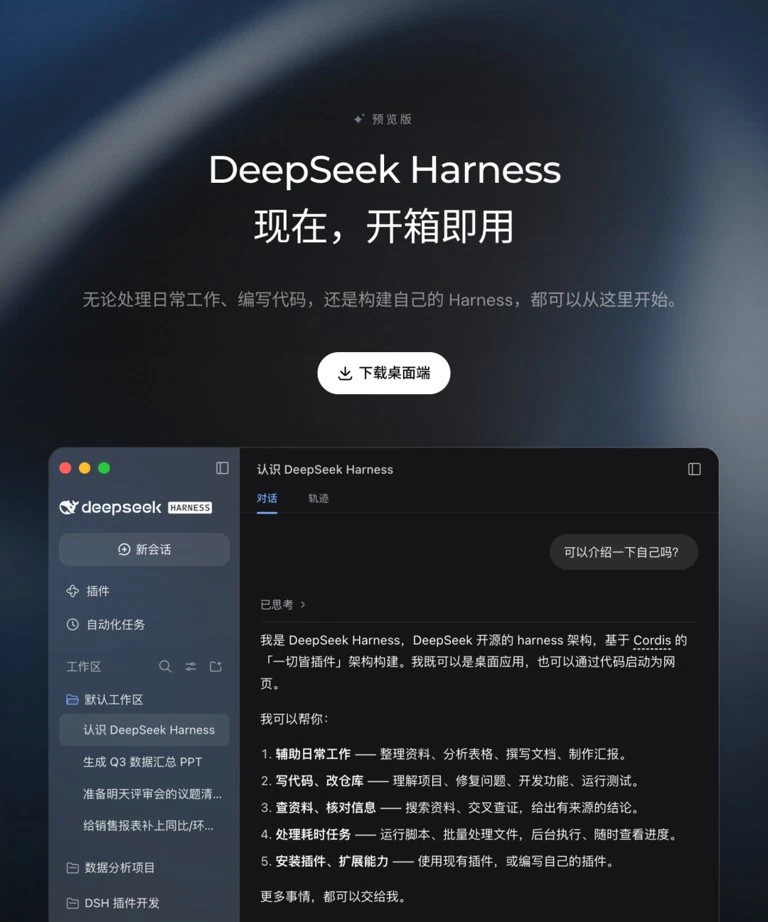
DeepSeek Harness
提供官方开源测试框架,一键标准化复现学术指标,透明可验证、拒绝黑盒。